В гонке ИИ уже мало выпустить самый быстрый ускоритель. Если данные подаются к нему медленно, сеть не успевает соединять тысячи узлов, а процессор тратит время на служебные операции, дорогие GPU простаивают. Поэтому Nvidia расширяет конкуренцию с уровня отдельного чипа до уровня всей стойки и даже дата-центра.
В материале
Новая платформа Vera Rubin объединяет несколько специализированных элементов: GPU Rubin выполняет основные вычисления, CPU Vera управляет данными и системными задачами, ускорители Groq 3 LPX обслуживают этап генерации ответа, а сеть Spectrum-X связывает узлы. Хранилище, память, охлаждение и программное обеспечение здесь не фон, а части одной производительной системы.
Это не означает, что Nvidia «смещает фокус с GPU» или отказывается от своего главного продукта. Точнее сказать, компания надстраивает вокруг GPU полноценную инфраструктуру. В исходном материале Rubin также был ошибочно назван CPU: Rubin — графический ускоритель, а центральный процессор платформы называется Vera.
Почему узким местом стало движение данных
Современная модель во время работы постоянно обращается к памяти, получает контекст, запускает инструменты и передаёт промежуточные результаты между ускорителями. Чем крупнее кластер, тем больше времени и энергии уходит не на арифметику, а на перемещение информации.
На этапе предварительной обработки запроса важна параллельная вычислительная мощность GPU. Во время последующей генерации токенов сильнее проявляются задержки памяти и обмена. Nvidia предлагает разделить эти роли: Rubin обрабатывает контекст, Vera координирует код, инструменты и потоки данных, а LPX ускоряет последовательный этап вывода.
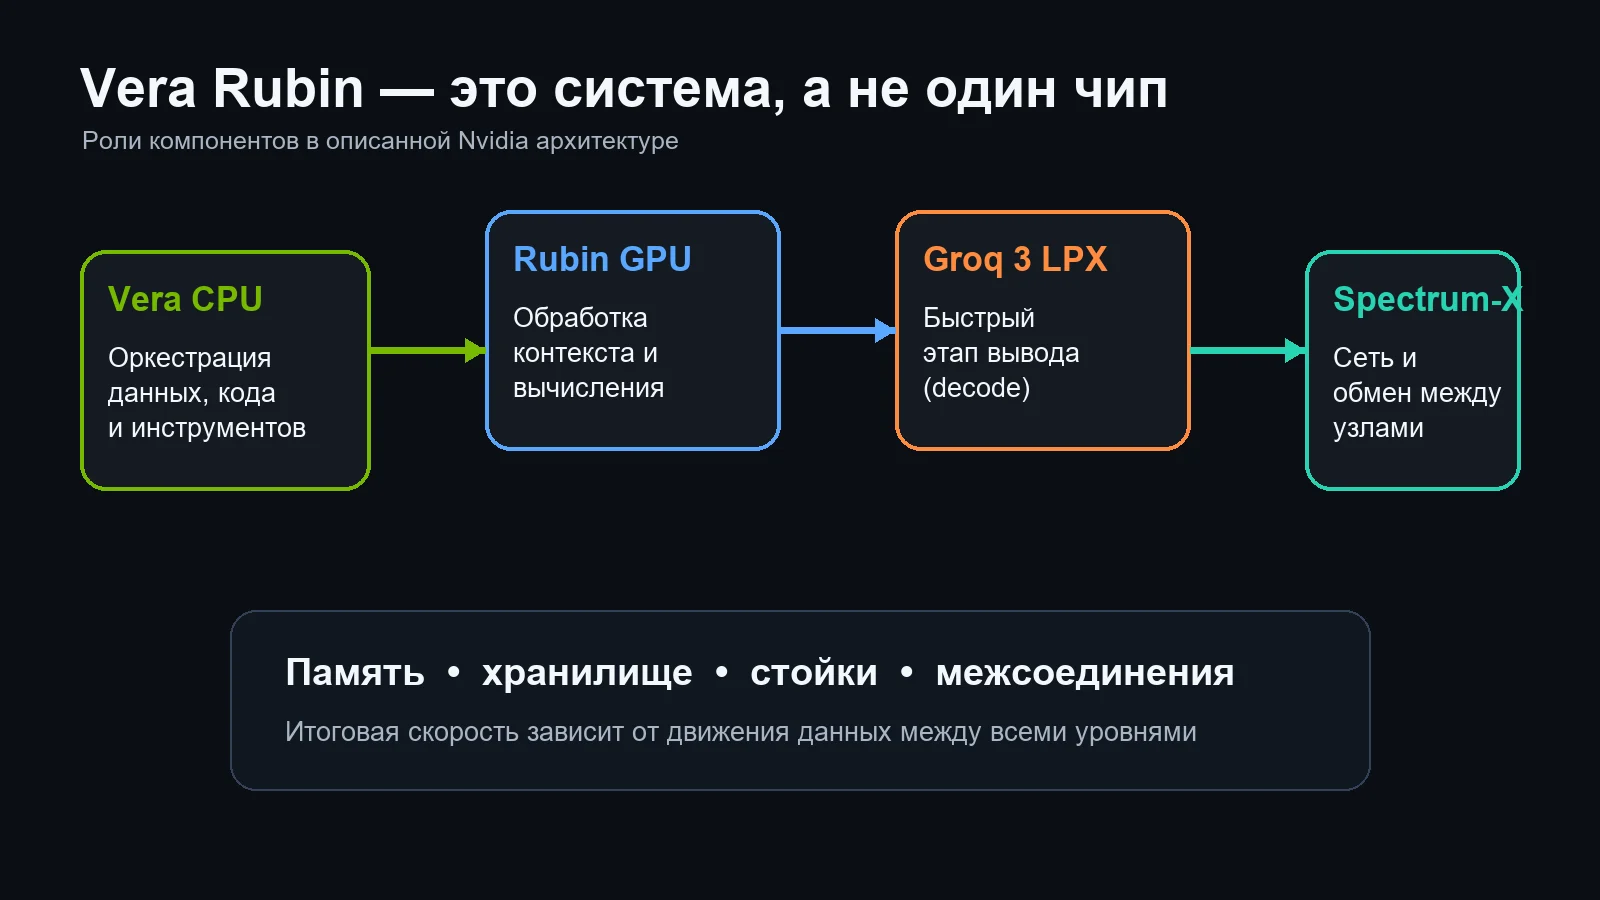
Упрощённая редакционная схема по материалам Nvidia. Она показывает распределение ролей, а не физическую компоновку конкретной стойки.
Такой подход называют disaggregated inference — раздельным выполнением разных частей одного запроса. Его плюс в том, что каждый тип оборудования получает подходящую ему работу. Минус — систему сложнее проектировать: выигрыш возможен только при достаточно быстрой сети и грамотном планировании нагрузки.
Что обещает Nvidia
Вице-президент Nvidia по технологиям хранения Джейсон Харди сообщил TechCrunch, что перенос части оркестрации на Vera CPU дал во внутренних испытаниях компании более чем трёхкратное улучшение некоторых операций. Это заявление производителя, а не независимый тест готового коммерческого дата-центра: неизвестны полный набор задач, исходная конфигурация и условия сравнения.
Для Groq 3 LPX Nvidia указывает 256 LPU в стойке, по 500 МБ SRAM на ускоритель, до 150 ТБ/с суммарной пропускной способности SRAM и 2,5 ТБ/с для масштабирования между ускорителями. Эти характеристики объясняют роль LPX: держать часто используемые данные рядом с вычислительными блоками и снижать задержку при генерации ответа.
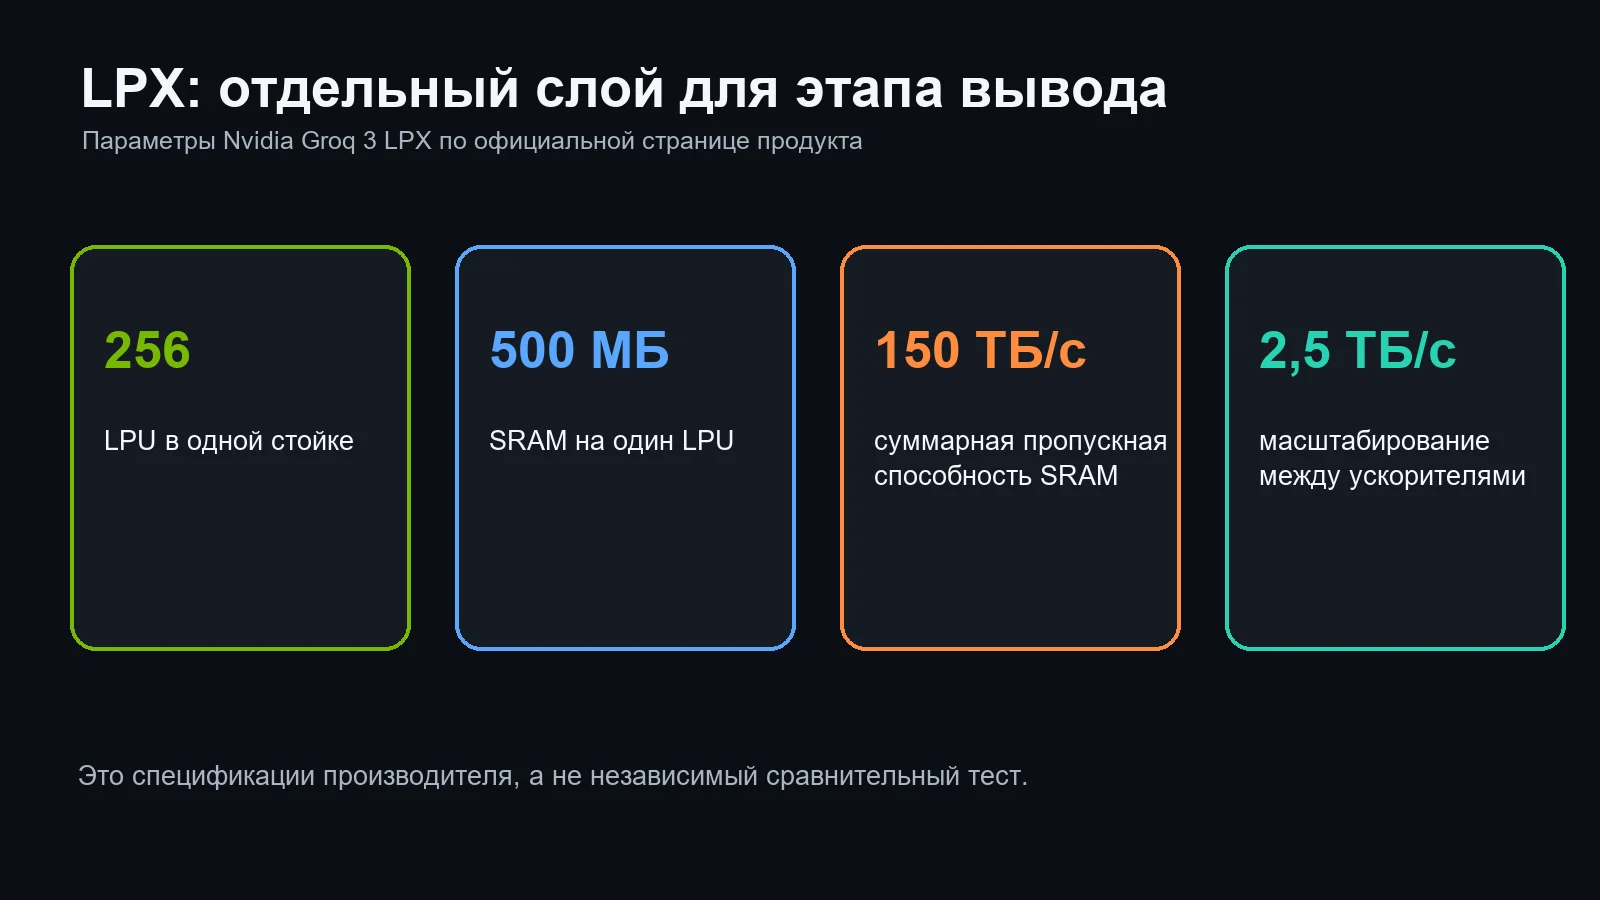
Спецификации с официальной страницы Nvidia LPX. Это данные производителя, а не независимое сравнение с альтернативными ускорителями.
Почему это важно для рынка
Раньше покупатель мог сравнивать ускорители по скорости и объёму памяти. Теперь крупному оператору приходится оценивать всю систему: производительность на ватт, загрузку GPU, пропускную способность сети, стоимость хранения, охлаждение, программные инструменты и время простоя.
Именно здесь Nvidia пытается закрепить преимущество экосистемы. Компания продаёт не только вычислительный чип, но и CPU, межсоединения, коммутаторы, эталонные стойки и программный стек. Для клиента это упрощает запуск кластера, однако усиливает зависимость от одного поставщика и усложняет замену отдельных компонентов.
У конкурентов есть другой путь: создавать более интегрированные ускорители и уменьшать число передач данных. TechCrunch приводит в пример проект OpenAI Jalapeño. Пока его характеристики и готовность к массовому применению нельзя сопоставить с Vera Rubin по открытым независимым тестам, поэтому говорить о победителе преждевременно.
Главный вывод проще: GPU остаётся центром ИИ-инфраструктуры, но уже не определяет результат в одиночку. Следующий этап конкуренции — это способность собрать вычисления, память, сеть и хранилище в систему, которая стабильно выполняет реальную нагрузку и не тратит дорогие ресурсы на ожидание данных.